Tema 7. Arquitectura Well-Architected¶
Una sola EC2 (Elastic Compute Cloud, nube elástica de cómputo) con MySQL local, una AMI (Amazon Machine Image, imagen de máquina de Amazon) hecha a mano y el puerto 3306 abierto al mundo funciona hasta el primer pico o el primer disco lleno. El Well-Architected Framework (marco de buena arquitectura, a menudo abreviado WA) es un vocabulario compartido para revisar una carga y decidir qué ganas y qué pagas cuando cambias el diseño: más zonas de disponibilidad (AZ, Availability Zone) mejoran la fiabilidad y suelen subir el coste; endurecer el SG (grupo de seguridad, security group) mejora la seguridad y a veces complica el acceso desde el aula. Este tema corresponde al Módulo 9 de AWS Academy Cloud Foundations. Nivel Practitioner: pilares y patrones cortos. Los términos clave están en el glosario.
Al empezar
Empieza por el cuestionario inicial. Antes de escalar (Tema 8), nombra por qué una AZ sola o un disco lleno te tumba el servicio: aquí justificas el equilibrio entre fiabilidad, coste y complejidad.
Propuesta didáctica¶
RA4. Gestiona servicios de almacenamiento y bases de datos en la nube, seleccionando tecnologías adecuadas para casos específicos, y diseña arquitecturas escalables y resilientes utilizando herramientas de monitoreo y optimización para mejorar el rendimiento.
Criterios de evaluación (RA4)¶
- d) Se ha diseñado arquitecturas escalables y resilientes basadas en las mejores prácticas.
- f) Se ha participado en actividades que simulen el análisis y mejora de arquitecturas existentes.
La monitorización fina es el Tema 8. Aquí CloudWatch aparece como práctica de excelencia operativa.
Contenidos¶
- Seis pilares y tensiones entre ellos.
- Varias AZ, desacoplo (SNS/SQS), IaC como idea.
- Well-Architected Tool y Trusted Advisor: existen; no son el entregable principal de PR701.
Programación de aula (orientativa)¶
| Quincena | En tutoría | Trabajo autónomo / evidencias |
|---|---|---|
| Q9 | Pilares WA + equilibrios Multi-AZ | PR701; Autocheck del tema |
Cuestionario inicial¶
Responde con lo que sepas
- ¿Para qué sirve el Well-Architected Framework en Foundations: argumentar cambios con pilares o memorizar logos de servicios?
- Poner la API (interfaz de programación de aplicaciones) en dos AZ mejora un pilar y suele empeorar otro: ¿cuáles?
- ¿SQS o SNS si un worker debe procesar «generar PDF» cuando pueda?
- Da un ejemplo de cambio en una app de un proyecto de DAW y el pilar que mejora (una frase).
- ¿Este módulo te pide diseñar un entorno de varias cuentas (landing zone) completo?
Este cuestionario es solo para ti: te ayuda a ver qué dominas ya y qué te falta antes o mientras lees el tema. No se entrega en Aules; respóndelo con lo que sepas y, cuando quieras contrastar, abre el bloque Soluciones (autoevaluación) debajo o el índice en Soluciones.
Soluciones (autoevaluación)
-
Sirve para argumentar cambios etiquetando pilares (qué mejora y qué empeora), no para memorizar logos.
-
Mejora fiabilidad; suele empeorar coste (y a veces la complejidad del trabajo de administración).
-
SQS: cola de trabajo para que el worker procese cuando pueda. SNS sería publicación/suscripción hacia varios destinatarios.
-
Ejemplo: pasar MySQL local a RDS Multi-AZ mejora el pilar fiabilidad (aceptas más coste).
-
No. Este módulo no pide un entorno de varias cuentas (landing zone).
Bloque Foundations (Módulo 9)¶
Los seis pilares del Well-Architected Framework son ejes de revisión de una carga en la nube: excelencia operativa, seguridad, fiabilidad, eficiencia del rendimiento, optimización de costes y sostenibilidad. No son una lista mágica de casillas: son preguntas sistemáticas. ¿Cómo desplegamos y qué aprendemos del incidente? ¿Quién accede a los datos? ¿Qué pasa si cae una AZ? ¿El tamaño del recurso encaja? ¿Pagamos ociosidad? ¿Usamos energía con sentido? Para una API de un proyecto de DAW sirven para argumentar un cambio («paso a Multi-AZ») sin pretender un diagrama de cuarenta cajas.
| Pilar | Pregunta que te haces | Ejemplo en una API de un proyecto de DAW |
|---|---|---|
| Excelencia operativa | ¿Cómo desplegamos, observamos y aprendemos cuando algo falla? | Plantillas repetibles, alarmas de CloudWatch y un procedimiento breve tras un incidente. |
| Seguridad | ¿Quién accede a los datos y cómo detectamos lo anómalo? | IAM de mínimo privilegio, HTTPS y un SG que no abre 3306 a internet. |
| Fiabilidad | ¿Qué pasa si se cae una AZ o un disco? | ALB con instancias en dos AZ y RDS con Multi-AZ. |
| Eficiencia del rendimiento | ¿El tipo y el tamaño del recurso encajan con la carga? | Elegir familia de instancia razonable y añadir caché solo si el acceso lo pide. |
| Optimización de costes | ¿Pagamos capacidad encendida sin uso? | Apagar el entorno de desarrollo de noche o usar Spot en trabajos por lotes. |
| Sostenibilidad | ¿La energía y el hardware se usan con sentido? | Ajustar el tamaño de los recursos y reducir instancias ociosas. |
Multi-AZ mejora la fiabilidad y sube el coste. Eso es evaluable en PR701. Un diagrama enorme sin justificar el equilibrio no lo es.
Cuando compares dos diseños en el CLF o en PR701, escribe la frase completa: «Paso la BD a RDS Multi-AZ: gano fiabilidad; pago más por la instancia de reserva y un poco más de complejidad de red». Esa frase es el entregable. Un logo de RDS sin el pilar y sin el coste aceptado no demuestra el CE f.
Otra tensión habitual es seguridad frente a comodidad en el aula. Abrir 3306 «solo un rato» para el cliente SQL del portátil parece inocente y deja el hábito en el repo. La alternativa Foundations (SG desde la API, un servidor bastión —EC2 en subred pública solo como puerta SSH a la red privada— o una VPN, red privada virtual) es menos cómoda el primer día y más defendible en un proyecto intermodular. Etiquetas el cambio como seguridad; aceptas complejidad de acceso.
El desacoplo también tensiona excelencia operativa: una cola SQS implica un worker, reintentos y, a veces, una cola de mensajes fallidos. Ganas resiliencia del HTTP; pagas un componente más que vigilar. En Foundations no montas todo eso en consola para PR701; sí debes poder decirlo en prosa.
Los pilares se tensan entre sí. Más AZ y más alarmas mejoran fiabilidad y excelencia operativa; también suman factura y complejidad. Ajustar el tamaño de los recursos mejora coste y sostenibilidad; mal hecho, empeora el rendimiento. En el entregable no busques el diagrama perfecto: busca justificar lo que ganas y lo que pagas.
Cuando la API y MySQL viven en la misma EC2, con AMI manual y SG abierto, un terminate o un disco lleno tumba todo a la vez. Un diseño más sólido separa el cómputo detrás de un ALB (Application Load Balancer, balanceador de carga de aplicaciones), reparte instancias en dos AZ, mueve la BD a RDS (Relational Database Service) con Multi-AZ, encola trabajos largos y pone alarmas. Cada uno de esos cambios se puede etiquetar con un pilar; ese es el ejercicio del CE f.
Excelencia operativa¶
Qué es en este caso. El pilar de excelencia operativa pregunta cómo ejecutas y evolucionas la carga: despliegues repetibles, observación (métricas, logs, alarmas) y aprendizaje tras incidentes. No es «tener muchas consolas abiertas»: es poder responder qué cambió, quién lo desplegó y cómo te enteras si la API deja de responder.
En la práctica. En Foundations no montas un centro de operaciones. Sí puedes decir: «si la API cae, CloudWatch me avisa» o «la infraestructura se describe en CloudFormation para no depender de clics olvidados». La IaC (Infrastructure as Code, infraestructura como código) es la idea de definir recursos en ficheros y desplegarlos igual en otro entorno. Conoces la idea; no entregas plantillas de trescientas líneas. Una guía operativa breve (runbook) de media página («si la alarma de 5xx salta, mira el ASG y el estado de RDS») ya cuenta como excelencia operativa en un proyecto de DAW.
Seguridad¶
Qué es en este caso. El pilar de seguridad cubre identidad, protección de datos, detección y respuesta: quién puede hacer qué, qué viaja cifrado y qué queda expuesto. Enlaza con el modelo de responsabilidad compartida del Tema 2: AWS cuida la nube; tú configuras identidades, SG y secretos.
En la práctica. Un SG con 3306 a 0.0.0.0/0 es una mala práctica de seguridad (y a menudo también de fiabilidad, porque el motor queda a merced de internet). Mínimo privilegio IAM (Identity and Access Management), HTTPS (Hypertext Transfer Protocol Secure) delante del ALB y secretos fuera del repositorio son cambios que etiquetas aquí. Cifrar un volumen EBS (Elastic Block Store) o forzar TLS en tránsito también caen en este pilar. Si en PR701 mueves MySQL a RDS en subred privada, el beneficio principal suele ser seguridad (aislamiento) aunque también ganes en fiabilidad.
Fiabilidad¶
Qué es en este caso. El pilar de fiabilidad pregunta si la carga aguanta fallos de componentes y de AZ, y si se recupera sin intervención heroica. Una arquitectura fiable no promete que nada falle: promete que el fallo de una pieza no tumba el servicio entero (o que la recuperación está ensayada).
En la práctica. Una sola AZ es un punto único de fallo del edificio. Dos AZ detrás de un ALB, RDS Multi-AZ y colas para trabajos no críticos del HTTP mejoran fiabilidad. Aceptas más coste y un poco más de complejidad de red. Las copias de seguridad y las instantáneas también son fiabilidad: si borras una tabla a las tres de la madrugada, ¿puedes volver atrás?
Eficiencia del rendimiento¶
Qué es en este caso. El pilar de eficiencia del rendimiento pregunta si eliges el tipo correcto de recurso y si usas bien la capacidad (caché, almacenamiento adecuado, familia de instancia). No es sinónimo de «más grande»: es «adecuado a la carga real».
En la práctica. Un t3.large 24/7 para una API de prácticas con pico a las 11:00 suele ser sobredimensionado. Ajustar el tamaño de los recursos (o apagar fuera de horario) conecta también con coste. No etiquetes todo como «rendimiento» solo porque hayas cambiado de tipo de instancia: di si el cuello era CPU, latencia o diseño (por ejemplo, faltaba una cola y el HTTP esperaba al PDF).
Optimización de costes¶
Qué es en este caso. El pilar de optimización de costes pregunta si pagas solo por lo que necesitas y si conoces el desglose. En el lab, el coste «invisible» suele ser la instancia o el volumen que nadie terminó.
En la práctica. Instancias de lab olvidadas, volúmenes EBS huérfanos y Multi-AZ «por costumbre» en un entorno de media hora disparan la factura. Spot encaja en trabajos por lotes que toleran interrupción; no en el checkout de la demo. En PR701, cuando mejores fiabilidad con Multi-AZ, declara el coste que aceptas: eso es el equilibrio que el CE f pide ver.
Sostenibilidad¶
Qué es en este caso. El pilar de sostenibilidad pregunta por el impacto ambiental del uso de recursos: menos capacidad ociosa, mejor aprovechamiento del hardware y patrones eficientes. AWS lo añadió como sexto pilar; en Foundations no hace falta un estudio de huella de carbono, sí hace falta no dejar capacidad encendida sin uso.
En la práctica. Apagar entornos que no usas y ajustar tamaños cuenta más que un párrafo genérico sobre el planeta. Suele ir de la mano del pilar de costes cuando reduces ociosidad: la misma acción (parar la EC2 de desarrollo por la noche) mejora ambos.
| Examen CLF (AWS Certified Cloud Practitioner, CLF-C02) | Clase DAW / empresa |
|---|---|
| Hay que etiquetar el escenario con un pilar. | En PR701 cada mejora lleva pilar y lo que empeora. |
| SQS es cola de trabajo; SNS es publicación/suscripción. | Tras un pedido, «generar PDF» pasa a SQS, no a SNS por defecto. |
| Varias AZ apuntan a fiabilidad, no a «más barato». | Dibuja dos AZ solo si justificas el coste. |
Patrones de resiliencia¶
La resiliencia es la capacidad de la carga para seguir prestando servicio (o recuperarse) cuando fallan componentes. En Foundations se concreta en patrones que ya has tocado por piezas:
Varias AZ en el plano de aplicación. El ALB reparte tráfico hacia instancias en al menos dos AZ. Si una zona cae, las de la otra siguen atendiendo (si el ASG —Auto Scaling group, grupo de autoescalado— o el diseño mantienen capacidad; el detalle de autoescalado es el Tema 8). En el diseño frágil de PR701 hay una sola EC2 en una AZ: el primer cambio de fiabilidad suele ser «dos AZ detrás del balanceador».
Desacoplo con cola de trabajo. Desacoplar significa que el productor no exige que el consumidor esté vivo en el mismo instante. Amazon SQS (Simple Queue Service, servicio simple de colas) es una cola de trabajo: el POST /pedidos responde 201 y encola «generar factura PDF»; el worker procesa cuando pueda. Si el worker cae, los mensajes esperan; el usuario ya tiene el pedido. Sin cola, el HTTP espera al PDF y el timeout tumba la experiencia en el pico de la demo. Ese patrón también protege el rendimiento percibido: la API responde rápido aunque el PDF tarde.
Publicación/suscripción. Amazon SNS (Simple Notification Service, servicio simple de notificaciones) publica un evento a varios suscriptores (correo, cola, función…). Encaja cuando varios destinos deben reaccionar al mismo hecho («pedido pagado» hacia correo al cliente, mensaje a almacén, métrica). No es la misma semántica que «un worker procesará este trabajo cuando pueda»: eso es SQS. En el CLF, si el enunciado dice «varios equipos deben enterarse», piensa SNS; si dice «un proceso procesará el mensaje más tarde», piensa SQS.
Sin estado en la instancia. Si las sesiones o los uploads viven solo en el disco de una EC2, la siguiente instancia detrás del ALB no los ve. Fotos en S3 y sesión en un almacén compartido (o un token JWT —JSON Web Token— sin estado en el servidor) son el patrón; enlaza con los Temas 5 y 6. Sustituir instancias enfermas (idea del Tema 8) solo funciona si la instancia es sustituible: si guarda datos locales, no se puede sustituir sin perderlos.
Multi-AZ en la BD. RDS Multi-AZ hace conmutación por error (failover): si cae la instancia principal, el servicio pasa a la de reserva. Mejora fiabilidad; sube coste. No escala por sí solo las consultas de informes (eso sería una réplica de lectura). En el diseño frágil, MySQL en la misma EC2 acopla el fallo del cómputo y el de los datos: separar a RDS ya es un salto; activar Multi-AZ es el siguiente.
IaC. CloudFormation o CDK describen la infraestructura para repetirla. En este módulo conoces la idea; sustituye la AMI «que solo tiene mi compañero» por un proceso repetible cuando justifiques excelencia operativa. No hace falta entregar la plantilla: hace falta decir por qué la AMI manual es frágil (no se versiona igual, no se revisa en PR, diverge entre alumnos).
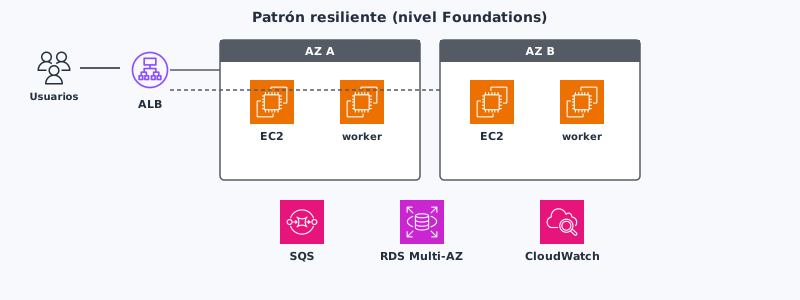
El análisis de PR701 (CE f) es decir qué pilar mejora si pasas de una EC2 con MySQL local a ALB + varias AZ + RDS, y qué aceptas a cambio.
Well-Architected Tool y Trusted Advisor¶
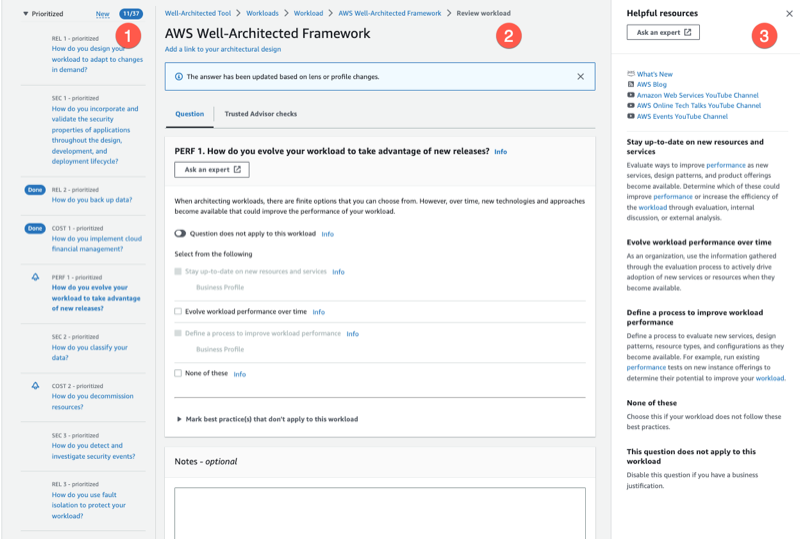
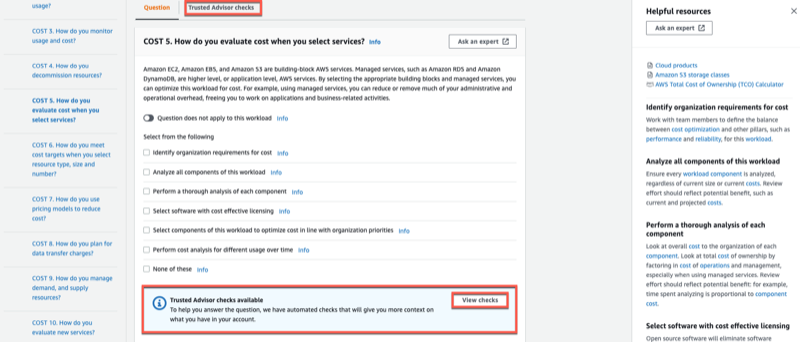
La Well-Architected Tool es un cuestionario en la consola organizado por pilares. Sirve para revisar una carga con preguntas guiadas (PERF, COST, SEC…). Creas un workload (la carga que describes), respondes y obtienes riesgos altos o medios por pilar. En muchas preguntas aparece el enlace a comprobaciones de Trusted Advisor, el servicio que sugiere mejoras de coste, seguridad, tolerancia a fallos y rendimiento según el plan de Support. Trusted Advisor no sustituye al marco WA: son comprobaciones automáticas; el marco es el vocabulario para discutir el diseño completo.
En Foundations basta saber que existen y para qué sirven. No son el entregable de PR701: la práctica de clase es el análisis en prosa. Si abres la Tool por curiosidad, no hace falta dejar un workload de lab colgado en la cuenta.
El Módulo 9 en Academy (sin laboratorio)¶
En AWS Academy Cloud Foundations, el Módulo 9 - Arquitectura en la nube no tiene ejercicio de laboratorio. Incluye secciones de teoría (principios de diseño del marco de buena arquitectura, los pilares, fiabilidad y disponibilidad, Trusted Advisor), el Student Guide y la evaluación de conocimientos del módulo. No vas a pulsar Start Lab aquí: el trabajo práctico de la quincena es de análisis.
La práctica de clase en este tema es PR701: partiendo de un diseño frágil, propones mejoras etiquetadas por pilar. Si haces la evaluación de conocimientos del Módulo 9, te ayuda a fijar vocabulario (por ejemplo distinguir SQS de SNS o asociar «varias AZ» a fiabilidad); no sustituye el entregable de las cinco mejoras. En el .md de PR701 puedes anotar si completaste esa evaluación; no es obligatoria para la rúbrica.
Errores frecuentes (diseño)¶
En un proyecto intermodular, el diseño frágil del enunciado de PR701 se parece a lo que montas la primera semana «para que compile»: una máquina, una base y un puerto abierto. El marco WA no te castiga por haber empezado así; te da nombres para decidir el siguiente paso sin improvisar. Cinco mejoras bien argumentadas valen más que un diagrama bonito sin pilares.
Si intentas «mejorar todo» a la vez sin decir qué pilar priorizas, el entregable se vuelve una lista de deseos. Elige cinco cambios distintos y, en cada uno, nombra el pilar principal y lo que empeora (coste, complejidad).
Usar SNS cuando necesitabas una cola de trabajo (o al revés) mezcla dos ideas distintas: la publicación/suscripción avisa a varios destinos; la cola guarda trabajos para un consumidor. Para «generar PDF cuando el worker pueda», SQS es la opción adecuada.
Declarar sostenibilidad sin ajustar tamaños ni apagar recursos ociosos deja el pilar en una frase vacía. En Foundations, reducir ociosidad es la prueba más creíble de ese pilar (y suele alinear con costes).
Proponer un entorno de varias cuentas o una malla de microservicios para una API de prácticas se sale del Módulo 9. Quédate en piezas Foundations: ALB, varias AZ, RDS, S3, IAM, SQS, CloudWatch.
Relación con Temas 3–6 y 8¶
Sin VPC multi-AZ (Tema 3), RDS Multi-AZ (Tema 6) y ALB/ASG (Tema 8), el discurso Well-Architected se queda en nombres sin piezas. Este tema nombra el equilibrio; los anteriores dan los bloques. El Tema 8 profundiza en escalado y monitorización: aquí solo situamos CloudWatch como excelencia operativa.
Si en el Tema 5 dejaste las fotos en el disco de la EC2, el pilar de fiabilidad (y a veces el de rendimiento) te empuja a S3. Si en el Tema 6 dejaste MySQL en la misma máquina que Express, fiabilidad y seguridad te empujan a RDS. PR701 es el momento de reunir esas decisiones en cinco frases con pilares, no de descubrir los servicios por primera vez.
Bloque Ampliación Practitioner (CLF-C02)¶
El Practitioner no pide un diagrama de cuarenta cajas: pide etiquetar el escenario con un pilar y no confundir una cola de trabajo (SQS) con una publicación/suscripción (SNS). Tampoco diseñas entornos de varias cuentas en este módulo. Preguntas típicas: «una empresa quiere reducir el tiempo de recuperación si falla una AZ» apunta a fiabilidad / Multi-AZ; «quiere cifrar datos en reposo» apunta a seguridad; «quiere pagar menos por instancias ociosas» apunta a optimización de costes (y a menudo sostenibilidad). Si el enunciado describe un mensaje que varios sistemas deben recibir, SNS; si describe un trabajo que un proceso procesará más tarde, SQS.
Para el CLF
Cifrar datos apunta a seguridad; las alarmas, a excelencia operativa; Spot o ajustar tamaños, a coste; varias AZ, a fiabilidad. SQS encaja cuando un worker procesará el mensaje; SNS, cuando varios suscriptores reaccionan al mismo evento. Ampliación y autocheck certificación en Certificación § Tema 7.
Videotutorial (Practitioner). AWS Well Architecting Framework (~1 h 52 min) — pilares del Well-Architected Framework. Vídeo: Profe Santos Cloud (YouTube).
Videotutorial¶
Principal (Foundations). AWS Architectura Discussions (~34 min).
Vídeo: Profe Santos Cloud (YouTube). Qué mirar: equilibrios (AZ, estado, coste); úsalo como vocabulario para PR701.
Actividad / práctica¶
PR701 — Mejorar un diagrama frágil¶
- PR701. (RA4 // d, f // PR 0–10). Partes de un diseño frágil (una EC2
t3.largeen una AZ, MySQL en la misma instancia, AMI manual, SG0.0.0.0/0en 3306, copias de seguridad en/home) y propones cinco mejoras en prosa, cada una etiquetada por pilar, sin montar el diagrama completo en consola.
Tareas: escribe cinco mejoras distintas. En cada una, en párrafos (no en una fórmula fija): el problema, el servicio o la práctica de Foundations, el pilar principal y qué mejora (y qué empeora: coste, complejidad). Opcional: haz la evaluación de conocimientos del Módulo 9 para fijar vocabulario.
Entrega: según Cómo entregar las prácticas — fichero PR701.md.
Guía de apoyo (no sustituye el enunciado): Soluciones · PR701.
| Criterio | Descripción | Puntos |
|---|---|---|
| Cinco mejoras | Completas y distintas | 0–4 |
| Pilares | Etiqueta correcta por mejora | 0–3 |
| Equilibrio | Qué mejora y qué empeora | 0–2 |
| Claridad | Prosa legible | 0–1 |
| Total | /10 |
Cómo leer un diseño frágil en cinco minutos¶
Empieza repasando el diseño: ¿una sola AZ? ¿estado en el disco local? ¿secretos en la AMI? ¿SG abierto? ¿sin alarmas? Prioriza seguridad y fiabilidad antes que adornos de rendimiento. Propón el cambio mínimo Foundations (RDS, Multi-AZ, ALB, S3, IAM, CloudWatch, SQS). Declara el coste o la complejidad que aceptas a cambio. Eso es el espíritu de PR701 y de muchas preguntas CLF del dominio de conceptos y arquitectura ligera.
Autocheck del tema¶
Comprueba pilares y desacoplo de este tema. CLF: Certificación § Tema 7.
- Cifrar EBS (Elastic Block Store) y forzar HTTPS: pilar que etiquetas primero…
a) sostenibilidad · b) seguridad · c) coste - Pasar de una AZ a dos con ALB: efecto principal…
a) fiabilidad · b) sostenibilidad · c) «más barato siempre» - V/F. SQS encaja para que un pico de pedidos no tumbe al worker que genera PDFs.
- CloudFormation es…
a) un pilar Well-Architected · b) una práctica / IaC que ayuda a la excelencia operativa - V/F. Este módulo exige montar un entorno de varias cuentas (landing zone).
Soluciones
-
b.
-
a.
-
Verdadero (cola de trabajo).
-
b.
-
Falso.
Glosario¶
Well-Architected AWS Well-Architected Framework (marco de buena arquitectura): conjunto de seis pilares para revisar cargas en la nube. Nivel Practitioner: reconocer el pilar ante un escenario y argumentar el equilibrio.
excelencia operativa Pilar que cubre despliegue, observación y aprendizaje tras incidentes.
seguridad (pilar) Pilar de identidad, protección de datos y detección.
fiabilidad Pilar de tolerancia a fallos y recuperación (varias AZ, conmutación, copias).
eficiencia del rendimiento Pilar de elección y uso adecuado de tipos de recurso.
optimización de costes Pilar de evitar gasto inútil y conocer el desglose.
sostenibilidad Pilar de uso eficiente de recursos y menor ociosidad.
resiliencia Capacidad de seguir prestando servicio o recuperarse cuando fallan componentes.
desacoplo Diseño en el que productor y consumidor no tienen que estar disponibles a la vez (p. ej. con una cola).
SQS Simple Queue Service (servicio simple de colas): cola de mensajes para trabajos. El productor encola aunque el worker esté caído o saturado.
SNS Simple Notification Service (servicio simple de notificaciones): publicación/suscripción hacia varios destinos.
IaC Infrastructure as Code (infraestructura como código): definir infraestructura en ficheros (p. ej. CloudFormation) para desplegar de forma repetible.
Well-Architected Tool Cuestionario en consola por pilares para revisar una carga; a menudo enlaza con Trusted Advisor.
Trusted Advisor Servicio de recomendaciones (coste, seguridad, tolerancia a fallos, rendimiento…) según el plan de Support.